Unser Produkt · BaseGPT · Forward Deployed
KI läuft dort, wo die Arbeit ist
Jeder will KI, aber an welcher Stelle?
Die Frage ist selten das Modell. Sie lautet: in welchem Vorgang, mit welchen Daten, in welchem System.
Ein Chat-Zugang für alle ist schnell eingerichtet. Ob er im Alltag hilft, entscheidet sich an der Stelle, an der die Arbeit passiert: im Angebot, im Service-Ticket, in der Prüfung eines Vertrags. Dort braucht die KI Ihre Begriffe, Ihre Quellen und Ihre Systeme, und sie muss wissen, worüber sie nicht sprechen darf.
Das lässt sich nicht aus der Ferne konfigurieren. Deshalb kommen wir ins Haus, sitzen bei den Menschen, die den Vorgang kennen, und integrieren genau diesen einen Ablauf. Woran Sie merken, dass er besser läuft, legen wir vorher gemeinsam fest.
Wie BaseGPT daran ansetzt
Ein Einsatz, ein Ablauf
Wir fangen bei einem Vorgang an, den Sie benennen können, und arbeiten mit echten Daten statt mit einer Demo.
Zuhören
Wir sitzen bei den Menschen, die den Vorgang heute erledigen: welcher Ablauf, welches System, welches Ergebnis.
Anschließen
Quellen, Rechte, Anbindungen. Das Modell spricht über das, was stimmt, und schweigt dort, wo es schweigen soll.
In den Ablauf
Derselbe Vorgang läuft mit Ihrem Team und echten Daten. Vorher und nachher ist messbar.
Der nächste
Updates, neue Quellen, der zweite Ablauf, so lange Sie uns im Haus haben möchten. Die Instanz läuft auch ohne uns weiter.
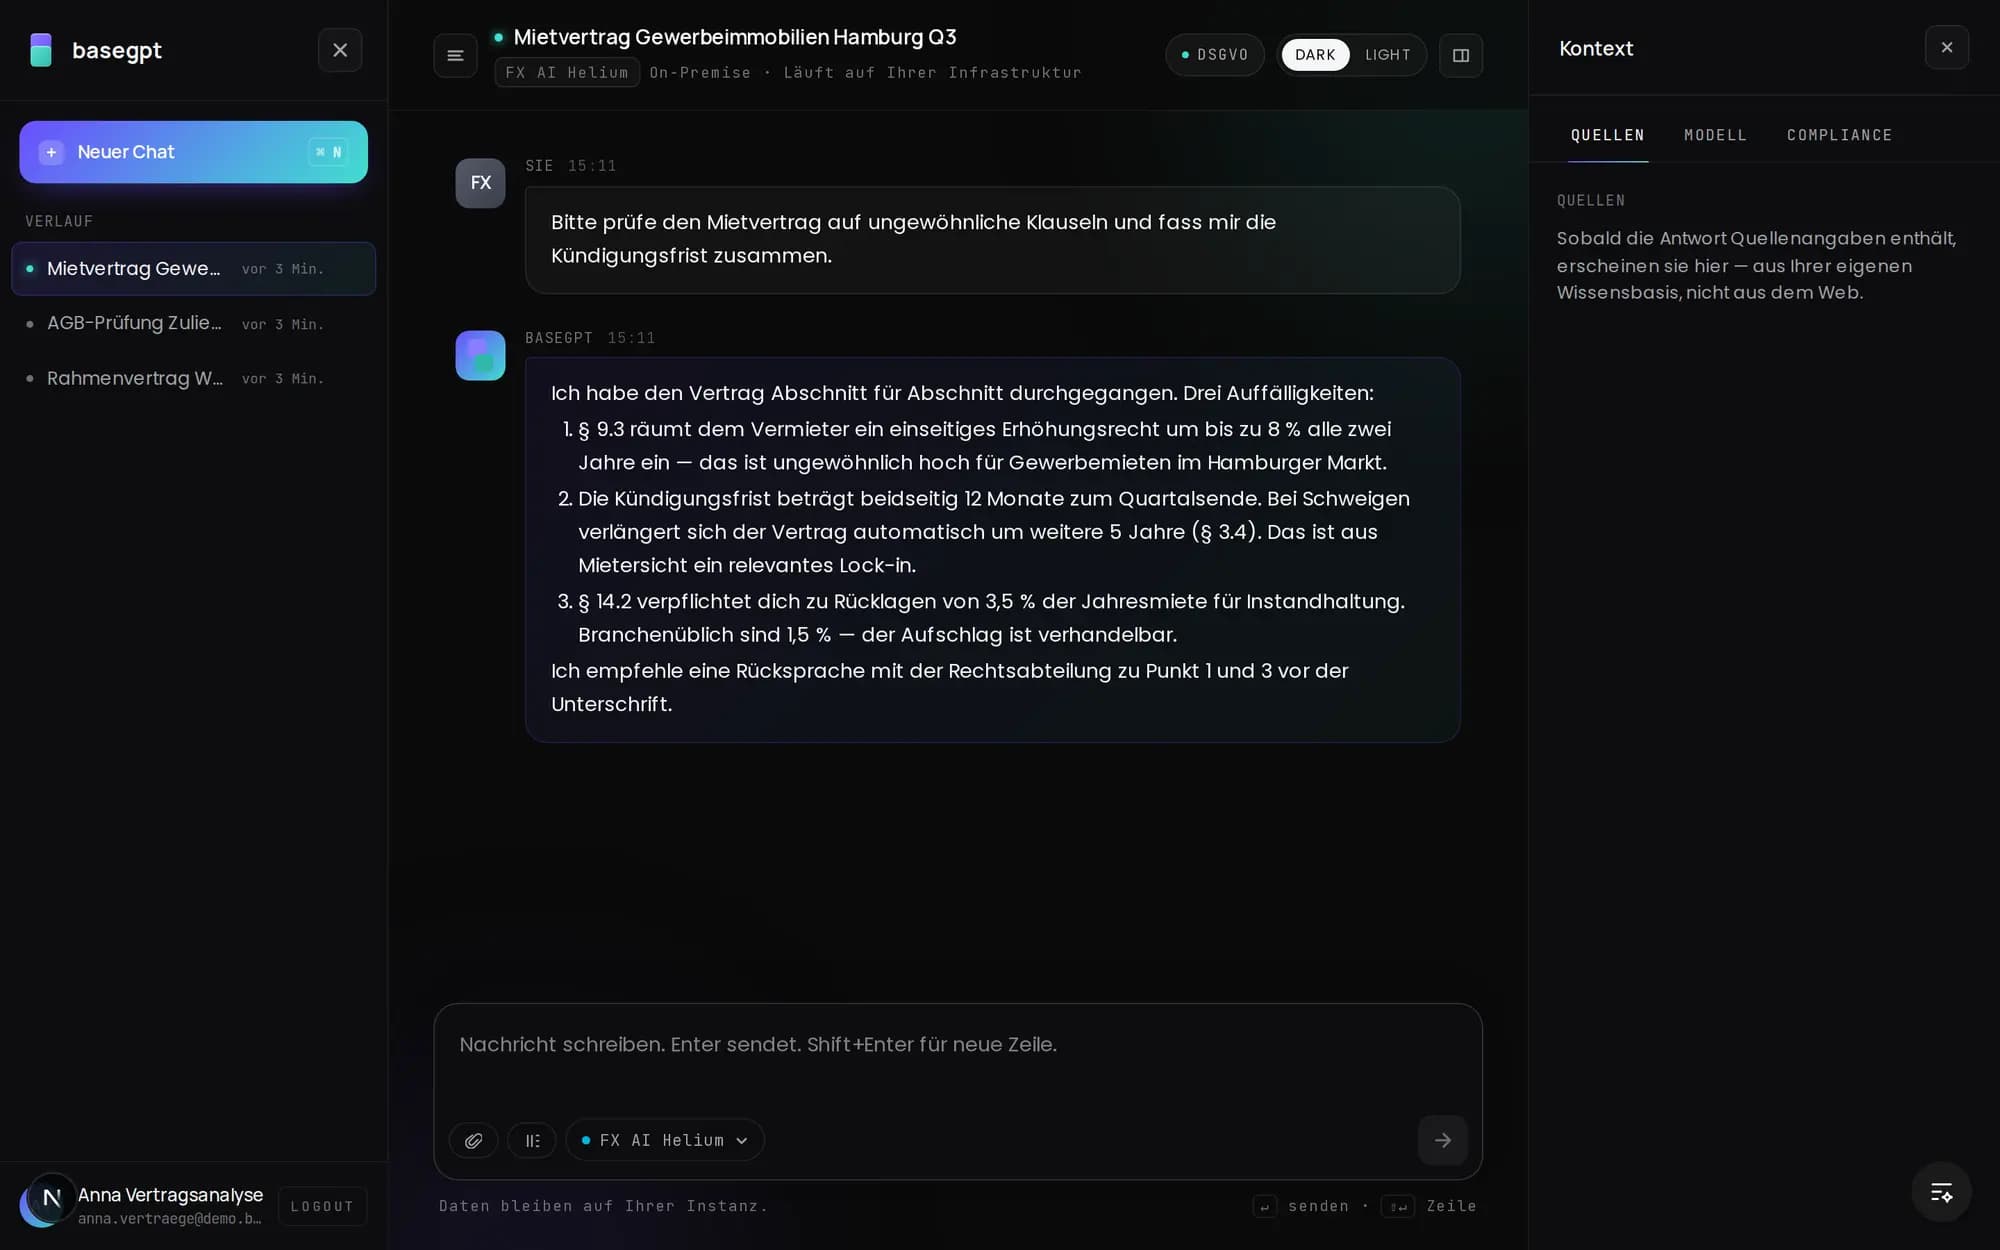
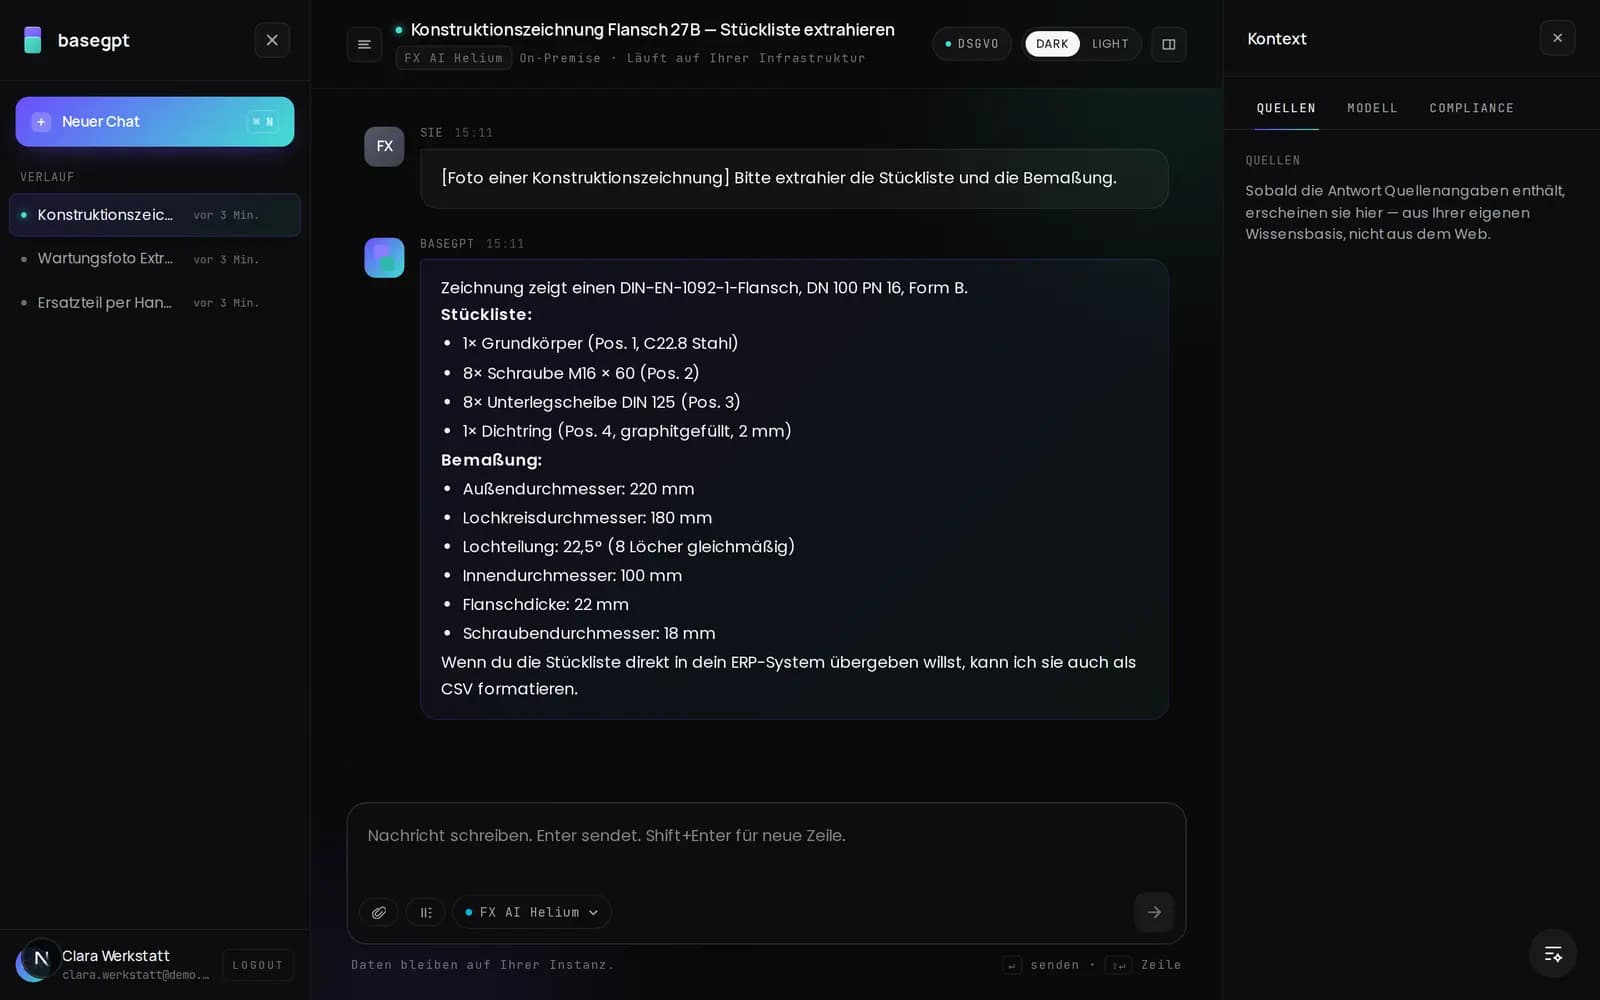
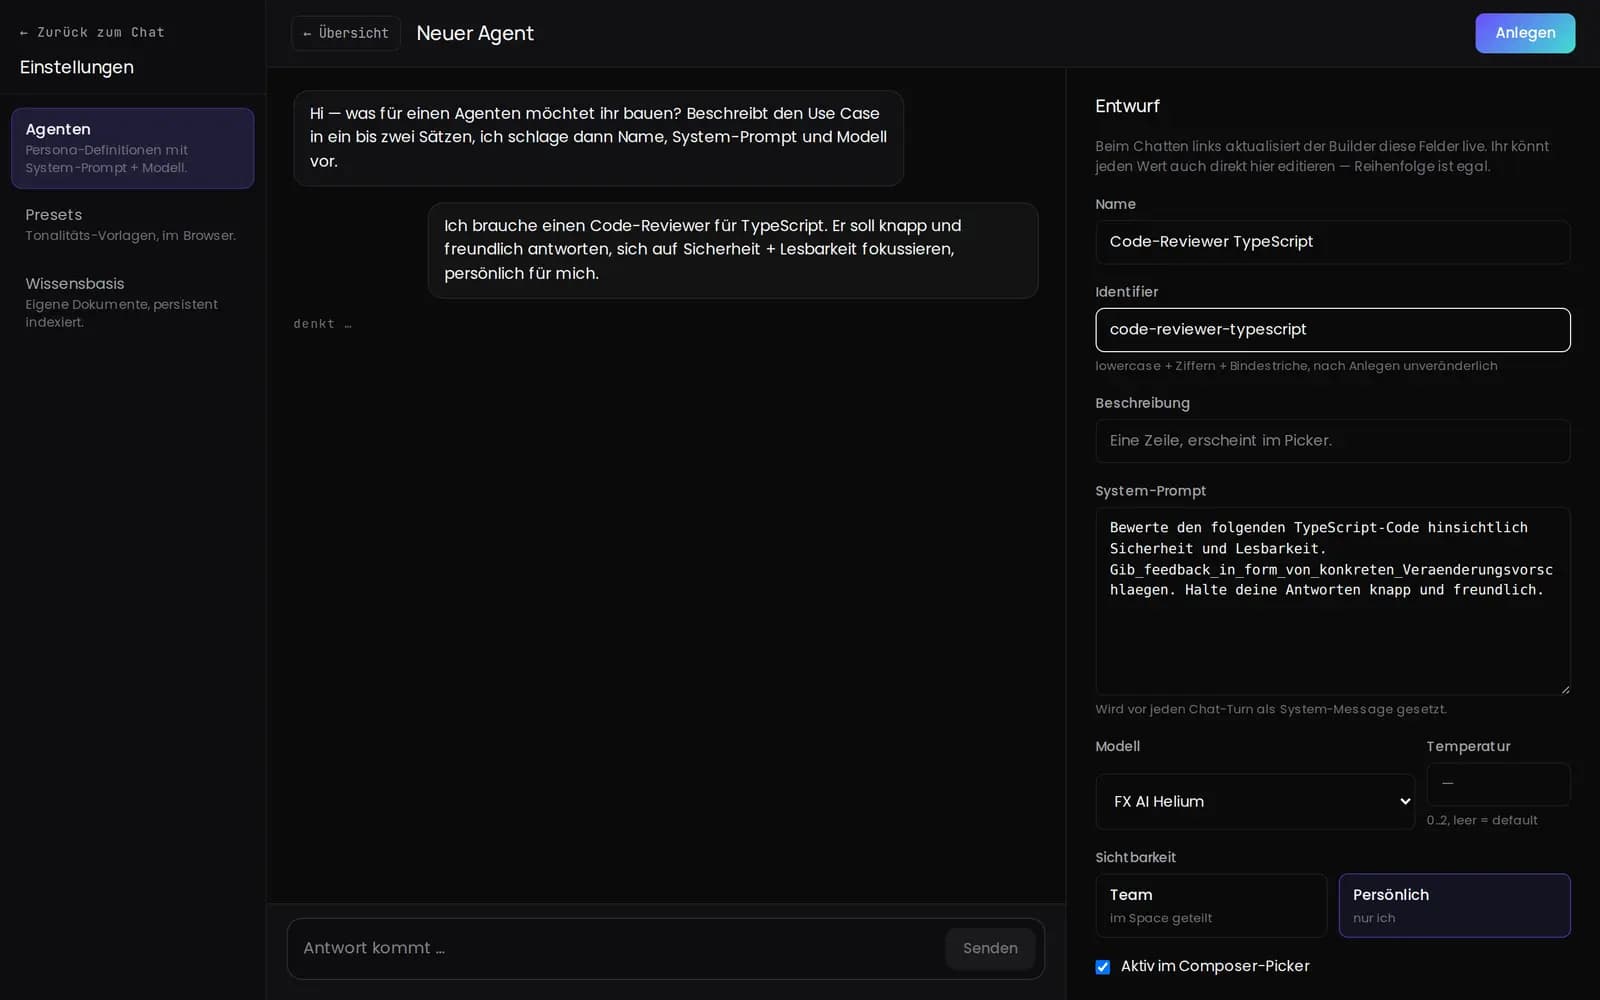
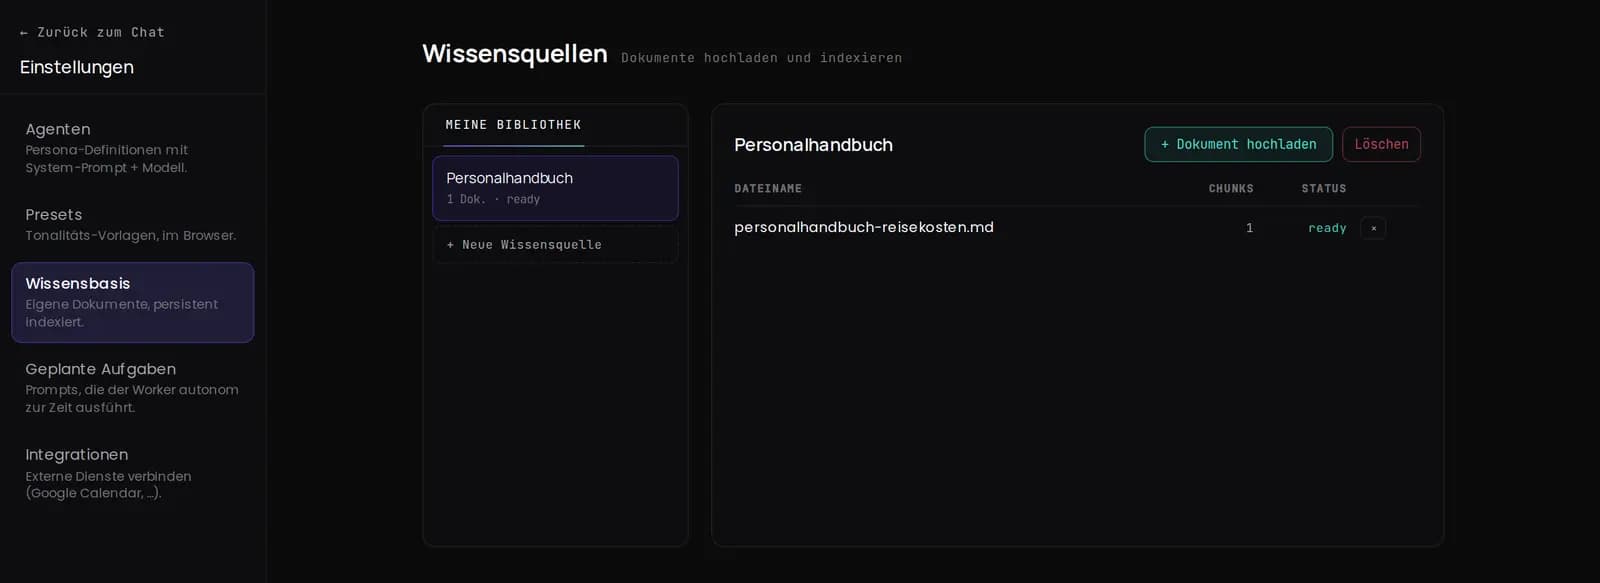
Chat, Agenten und Wissensquellen aus der Demo-Instanz
Die Screenshots stammen aus der aktuellen Version, mit Demo-Konten und Beispieldaten.
Die Plattform bleibt bei Ihnen
Modelle, Wissen, Rechte und Oberfläche sind austauschbar. Alles läuft innerhalb Ihrer Instanz.
Chat mit Wissensbasis
Assistenten & Agenten
Presets & Feinsteuerung
BYOK über LiteLLM
Keycloak, Rollen & Audit
Budget & Spend-Log
API & Integration
Fine-Tuning bei Bedarf
Ihre Server, Ihre Regeln
On-Premises-Kubernetes, Bare-Metal oder ein deutsches Rechenzentrum Ihrer Wahl, jeweils mit demselben Stack.
Isolierte Kundeninstanz
Jeder Kunde bekommt eine eigene Instanz mit eigener Postgres-Datenbank, eigenem nginx und eigenen Secrets. Ihre Daten liegen in Ihrer Instanz und nirgends sonst.
Bootstrap in unter einer Stunde
Ein Befehl richtet Datenbank, LiteLLM, API, Chat und nginx ein, wiederholbar und mit einem Root-Admin als Startpunkt. Backup-Runbook und TLS gehören dazu.
Daten bleiben im Haus
Nach außen gehen weder Telemetrie noch Analytics. Eine Anfrage verlässt die EU nur, wenn Sie für ein Modell bewusst den Schlüssel eines US-Anbieters hinterlegen, und das entscheiden Sie pro Assistent.
Audit-Trails, PII-Masking, Rollen und der Auftragsverarbeitungsvertrag samt TOMs sind vom ersten Tag an dabei. Wie wir Modelle sonst noch betreiben, in Frankfurt oder bei Ihnen, beschreibt die Seite zu KI-Hosting und Self-Hosted LLMs.
Das Modell wählen Sie pro Use Case
Wir betreiben die offenen Modelle, die zu Ihrer Hardware und Ihren Antworten passen, und binden Ihre Anbieter-Schlüssel über LiteLLM an.
Offene Modelle, selbst betrieben
Anbieter per BYOK
Ihre Schlüssel, Ihre Verträge. Tokens, Latenz und Kosten sehen Sie auf der Rechnung Ihres Providers.
Erst der Einsatz, dann der nächste Ablauf
Sie buchen die Integration eines Ablaufs. Die Instanz ist dabei, Modellkosten zahlen Sie direkt beim Provider.
BaseGPT
enthalten, auf Ihrer Infrastruktur
- Kundeninstanz
- Chat und Wissensbasis
- Keycloak und Audit
- LiteLLM und BYOK
- Beliebig viele Modelle und Nutzer
Der Einsatz
bei Ihnen, ein Vorgang, messbar
- Vor Ort bei Ihrem Team
- Ein Vorgang mit Owner
- Begriffe, Quellen und Anbindungen
- Was das Modell nicht sagen darf
- Vorher und nachher messbar
Danach
im Gespräch festgelegt
- Budget pro Nutzer
- Spend-Log für das Controlling
- Updates der Instanz
- Weitere Abläufe als Ausbau
BaseGPT im Detail
Was ist BaseGPT?
BaseGPT ist eine KI-Plattform mit Chat, Wissensbasis, Assistenten, Rollen und Audit, die auf Ihrer eigenen Hardware oder in einem deutschen Rechenzentrum Ihrer Wahl läuft. Sie bleibt bei Ihnen, nachdem wir als Forward Deployed Engineers einen ersten Ablauf mit Ihrem Team integriert haben. BaseGPT ist ein Produkt der CODING 9 GmbH.
Was bedeutet Forward Deployed?
Wir kommen ins Haus und setzen uns zu den Menschen, die einen Vorgang heute erledigen. Gemeinsam wählen wir einen Ablauf, hängen ihn an die Systeme, die schon da sind, und messen vorher und nachher. Die Arbeit passiert bei Ihnen vor Ort, nicht über ein Portal.
Was kostet BaseGPT im laufenden Betrieb?
Die Instanz gehört zum Einsatz, für den Bootstrap gibt es keine eigene Rechnung. Modellkosten zahlen Sie per BYOK direkt bei Ihrem Provider, mit einem Deckel pro Nutzer in der Admin-Konsole. Was wir danach pflegen, etwa Anbindungen, Updates und weitere Abläufe, legen wir am ersten Ablauf gemeinsam fest.
Was ist in der Instanz enthalten?
Bootstrap auf Ihrer Infrastruktur, Keycloak für Identität und Rollen, das LiteLLM-Gateway, die Chat-Oberfläche, die Wissensbasis (RAG), ein Backup-Runbook und TLS. Der Einsatz hängt einen Ablauf daran: Begriffe, Quellen, Anbindungen und was das Modell nicht sagen darf.
Welche Modelle laufen in BaseGPT?
Die, die zu Ihrem Ablauf und Ihrer Hardware passen. Über LiteLLM routet BaseGPT Anfragen an Anbieter wie OpenAI, Anthropic, Mistral, DeepInfra oder Azure OpenAI, jeweils mit Ihrem eigenen Schlüssel, oder an lokal betriebene offene Modelle wie Llama, Mistral, Qwen, DeepSeek oder Gemma. Ein Wechsel ist eine Zeile in der Konfiguration.
Wo liegen die Daten?
Auf Ihrer Instanz, auf Ihrer Hardware oder in einem deutschen Rechenzentrum Ihrer Wahl. Jede Kundeninstanz hat eine eigene Datenbank, einen eigenen Webserver und eigene Secrets, nach außen gehen keine Telemetrie und keine Analytics. Eine Anfrage verlässt die EU nur, wenn Sie für ein Modell bewusst den Schlüssel eines US-Anbieters hinterlegen, und das entscheiden Sie pro Assistent.
Trainiert ihr ein eigenes Modell für uns?
Wenn ein Ablauf Ihre Fachsprache braucht, trainieren wir ein offenes Modell auf Ihre Quellen. Oft reicht die Anbindung an die vorhandenen Dokumente und Systeme. Welcher Weg trägt, sagen wir Ihnen, bevor wir anfangen.
Können wir mit einem Ablauf starten?
Genau so fangen wir an: mit einem Vorgang, den Sie benennen können. Weitere Abläufe kommen dazu, ohne die Infrastruktur neu aufzusetzen.
Sagen Sie uns, wo KI bei Ihnen hängen bleibt
30 Minuten, ohne Folien. Sie beschreiben einen Ablauf, wir sagen Ihnen, wie wir ihn angehen und ob BaseGPT der richtige Unterbau dafür ist.